الذاكرة العربية المفقودة رقميا.. ما لا تستطيع الآلة قراءته
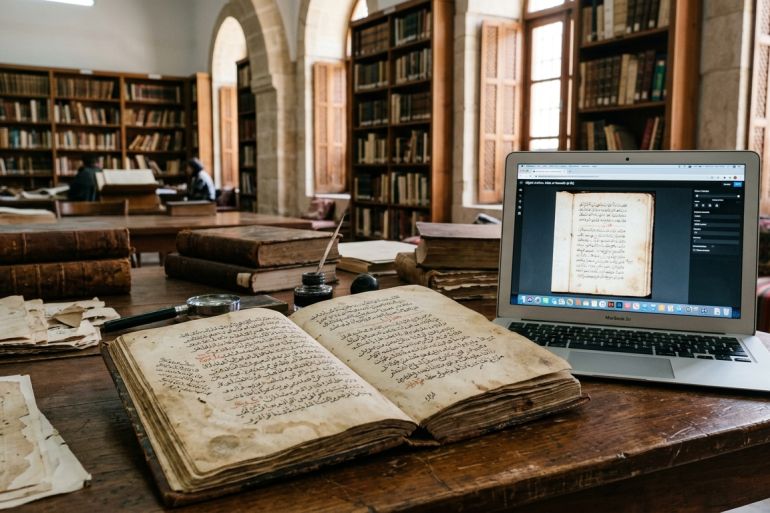

في المكتبات والأرشيفات العربية، تتراكم ذاكرة واسعة من الكتب والصحف والمخطوطات والوثائق التي نجت من التلف والضياع، وبعضها نجا أيضا من العزلة داخل الرفوف بعدما جرى تصويره وحفظه رقميا. لكن الانتقال من الورق إلى الشاشة لا يعني بالضرورة أن هذه الذاكرة أصبحت حاضرة في العالم الرقمي.
فالصفحة المصورة تظل، بالنسبة إلى الحاسوب، صورة قبل أن تكون نصا، ولا يستطيع محرك بحث أن يجد كلمة داخلها كما يفعل مع نص رقمي، ولا يستطيع نموذج ذكاء اصطناعي التعامل معها بالطريقة نفسها التي يتعامل بها مع نص قابل للقراءة الآلية.
قصص مقترحة
list of 2 itemsهنا تقع الفجوة التي تواجه رقمنة الذاكرة العربية؛ إذ إن كمية هائلة من المعرفة يمكن حفظها رقميا، لكنها لا تزال بعيدة عن أن تصبح بيانات تستطيع الآلة قراءتها وفهرستها وتحليلها.
وتزداد المشكلة تعقيدا عندما يتعلق الأمر بمخطوطات قديمة، أو صحف متضررة، أو وثائق مكتوبة بخطوط عربية متنوعة، حيث لا يكفي التصوير وحده. فهناك حاجة إلى تقنيات تتعرف على النص، وتُفكك بنيته، وتتعامل مع أخطائه، ثم تربطه بسياقه وبياناته الوصفية.
من هنا تبدأ قصة أخرى للرقمنة؛ ليست قصة تحويل الورق إلى ملفات، بل تحويل الذاكرة المحفوظة إلى بيانات قابلة للقراءة الآلية.
من صورة محفوظة إلى بيانات قابلة للقراءة
الطريق من صفحة ورقية إلى مادة يمكن للذكاء الاصطناعي التعامل معها لا يتوقف عند المسح الضوئي. هنا تأتي تقنيات التعرف الضوئي على الحروف "أو سي آر" (OCR)، في حين تُستخدم تقنيات التعرف على الكتابة اليدوية "إتش تي آر" (HTR) للتعامل مع الوثائق والمخطوطات المكتوبة بخط اليد.
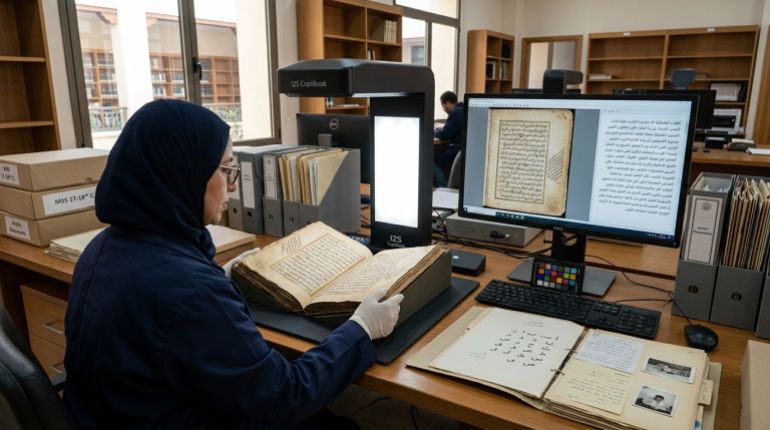
لكن تدريب هذه الأنظمة يحتاج بدوره إلى كميات كبيرة من البيانات. وتكشف مجموعة "سرد" (SARD)، التي نشرها باحثون من جامعة الأمير سلطان وأكاديمية طويق السعودية في سبتمبر/أيلول 2026، عن حجم هذا الاحتياج بأكثر من 2.6 مليون صورة لصفحات عربية، تحتوي مجتمعة على نحو 794.6 مليون كلمة، وصُممت لتدريب واختبار أنظمة التعرف على النصوص العربية في صفحات تحاكي تخطيطات الكتب.
واللافت أن "سرد" لا تمثل أرشيف مخطوطات تاريخية جرى إنقاذها، بل هي مجموعة بيانات اصطناعية. فقد استخدم الباحثون نصوصا عربية رقمية من مكتبة الألوكة، ثم حولوها إلى صور صفحات مع الحفاظ على النص الأصلي بوصفه مرجعا صحيحا لتدريب النماذج وتقييمها.
وتوفر هذه الطريقة حجما كبيرا من البيانات مع نصوص مرجعية معروفة، لكنها تترك سؤالا آخر يتعلق بالانتقال من البيئة المنظمة إلى الوثائق الموجودة فعليا في المكتبات والأرشيفات.
لماذا تحتاج الآلة إلى كل هذه البيانات؟
يوضح وديع بوعليلة، مدير مختبر الروبوتات وإنترنت الأشياء (RIOTU Lab) في جامعة الأمير سلطان في الرياض وأحد الباحثين في بناء "سرد" أن الدافع الأساسي وراء المجموعة كان سدّ فجوة في البيانات اللازمة لتطوير تقنيات قراءة الوثائق العربية. فالمجموعات السابقة قدمت إسهامات مهمة، لكن كثيرا منها ركز على الحروف أو الكلمات أو الأسطر المنفردة، أو كان محدودا من حيث الحجم والتنوع الطباعي وتمثيل الصفحة الكاملة.
ويوضح -في حديثه للجزيرة نت- أن الهدف كان توفير بيانات تساعد النماذج على قراءة صفحات كاملة تشبه الكتب المطبوعة، مع اختلاف الخطوط وكثافة النصوص. وأتاح التوليد الاصطناعي إنتاج هذا الحجم من البيانات مع إقران الصور بالنصوص المرجعية المستخدمة في إنشائها، وهو ما يقلل تكلفة التفريغ اليدوي ويوفر أساسا لتطوير أنظمة التعرف الضوئي على الحروف والنماذج التي تجمع بين الرؤية واللغة.
لكن بوعليلة يشدد -في حديثه للجزيرة نت- على أن "سرد" لا تمثل الأرشيف العربي الحقيقي بكل تعقيداته. فهي تحاكي صفحات الكتب ضمن تنسيقات مضبوطة، ولا تغطي جميع التخطيطات المعقدة أو عيوب الوثائق القديمة.
ولهذا يتطلب الانتقال إلى التطبيقات الواقعية استكمال التدريب والتقييم ببيانات مأخوذة من الوثائق الفعلية. ويشير بوعليلة إلى أهمية التعاون مع المكتبات ومراكز الأرشيف لجمع عينات متنوعة، وإعداد نصوصها المرجعية بمراجعة متخصصين، ثم تكييف النماذج معها.
ويمكن دعم التدريب أيضا بمحاكاة عيوب التصوير والطباعة، لكن اختبار النماذج، بحسبه، يجب أن يشمل وثائق حقيقية لم تدخل في التدريب، ويفضل أن تأتي من مصادر مختلفة، للتأكد من قدرتها على التعامل مع مواد جديدة.
ويرى بوعليلة أن التحدي لا يتعلق بقراءة الحروف فقط، بل بفهم بنية الصفحة، بما يشمل ترتيب الأعمدة وتمييز العناوين والحواشي وربطها بالمتن. أما المخطوطات فتحتاج إلى بيانات وخبرات متخصصة في الكتابة اليدوية والخطوط التاريخية، ويقول "النجاح في قراءة النص المطبوع لا يعني تلقائيا النجاح في قراءة المخطوطات".
ومن منظور فريقه في مختبر الروبوتات وإنترنت الأشياء، يتطلب هذا المسار الجمع بين الذكاء الاصطناعي وخبرة المختصين باللغة والتراث، مع مراجعة بشرية للمقاطع غير المؤكدة وربط النص المستخرج بصورته الأصلية.
فالهدف، كما يقول، ليس مجرد استخراج نص من ملايين الصفحات، وإنما إتاحة التراث العربي للبحث والمعرفة مع الحفاظ على أمانة نقله وتفاصيله التاريخية.
عندما تواجه الآلة الوثيقة القديمة
لكن الانتقال إلى الوثائق الحقيقية يفتح طبقة أخرى من التحديات. فبحسب المهندس الرئيسي في معهد قطر لبحوث الحوسبة، حمدي مبارك، لا تتعلق قراءة الوثائق العربية القديمة بالتعرف على الحروف وحدها، وإنما باستعادة وثيقة كاملة فقدت أجزاء من بنيتها الأصلية أثناء الرقمنة.
ويوضح حمدي -في حديثه للجزيرة نت- أن الصعوبات تبدأ من حالة الوثيقة نفسها، فضعف جودة المسح الضوئي، واصفرار الورق أو تلفه، وبقع الحبر، وعدم انتظام الصفحات، وتشابك الحروف العربية، وغياب التشكيل، واختلاف أشكال الخطوط والطباعة القديمة، كلها عوامل تؤثر في قدرة النظام على قراءة النص.
وفي الصحف، تضاف مشكلات أخرى بسبب تعدد الأعمدة والعناوين والإعلانات والحواشي وتداخل النصوص والصور، مما يجعل التعرف على الكلمات وحدها غير كاف لاستعادة الصفحة كما كانت في أصلها.
ويوضح كيف تحمل الأخطاء في العربية حساسية إضافية، إذ يمكن لخطأ صغير في حرف واحد أن يحول الكلمة إلى كلمة عربية أخرى صحيحة لغويا، لكنها مختلفة تماما في المعنى. كما قد تستخدم النصوص القديمة تهجئات وأساليب كتابة تختلف عن الاستخدام الحديث، فينجح النظام في قراءة الكلمات بصريا، لكنه يخطئ في فهمها أو التعامل معها وفق سياقها التاريخي.
النص المستخرج يحتاج إلى تدقيق
ولا تنتهي العملية بمجرد الحصول على ملف نصي قابل للبحث. إذ يؤكد مبارك في هذا السياق أن استخراج النص يمثل بداية العمل، إذ يحتاج المحتوى قبل استخدامه في التدريب أو أنظمة استرجاع المعلومات إلى ضبط الجودة والتنظيف والتوصيف.
ويرى أنه من المهم الاحتفاظ بالرابط بين النص والصفحة الأصلية، ومعالجة ترتيب القراءة، خصوصا في الصحف متعددة الأعمدة، وفصل الحواشي والعناوين والتعليقات عن النص الأساسي. كما ينبغي الاحتفاظ بمعلومات المصدر، مثل اسم الكتاب أو الصحيفة، والمؤلف، والتاريخ، والطبعة ورقم الصفحة.
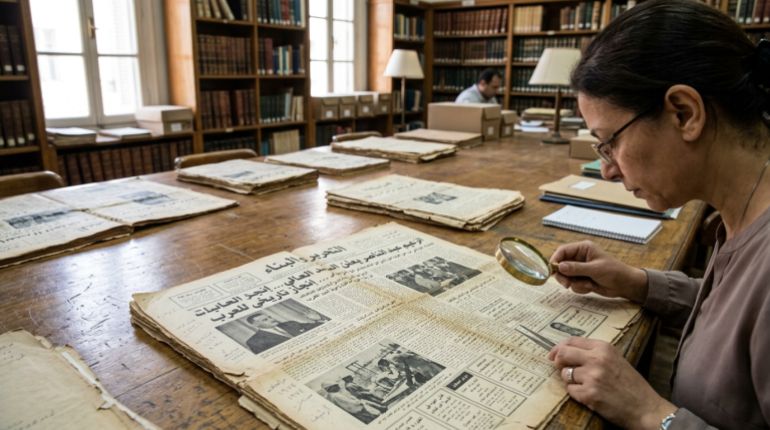
ويحذر مبارك من التعامل مع مخرجات التعرف الضوئي على الحروف (أو سي آر) باعتبارها "حقيقة" لمجرد أنها أصبحت نصا قابلا للبحث. ويرى أن من الضروري وجود مستوى من الثقة أو الجودة لكل صفحة أو مقطع، مع مراجعة العينات منخفضة الجودة بشريا، خصوصا عندما تُستخدم المادة في بناء مجموعات بيانات تدريبية.
عندما تنتقل الأخطاء إلى الذكاء الاصطناعي
تكمن أهمية هذه المراجعة في أن أخطاء "أو سي آر" يمكن أن تتجاوز الوثيقة التي نشأت فيها. فقد يتحول اسم شخص أو مكان إلى كلمة أخرى، أو تتغير الأرقام والتواريخ، أو تختلط أعمدة الصفحة، أو تفقد جملة بسبب مشكلة في التخطيط.
ويقول مبارك إنه مع تكرار هذه الأخطاء عبر ملايين الصفحات، يمكن أن تصبح جزءا من البيانات التي تتعلم منها النماذج. وفي أنظمة استرجاع المعلومات، قد يؤدي خطأ في اسم شخص أو مكان أو مصطلح إلى عدم العثور على الوثيقة عند البحث عنها. أما في النماذج التوليدية، فقد يتعلم النموذج النص المشوه باعتباره صيغة صحيحة.
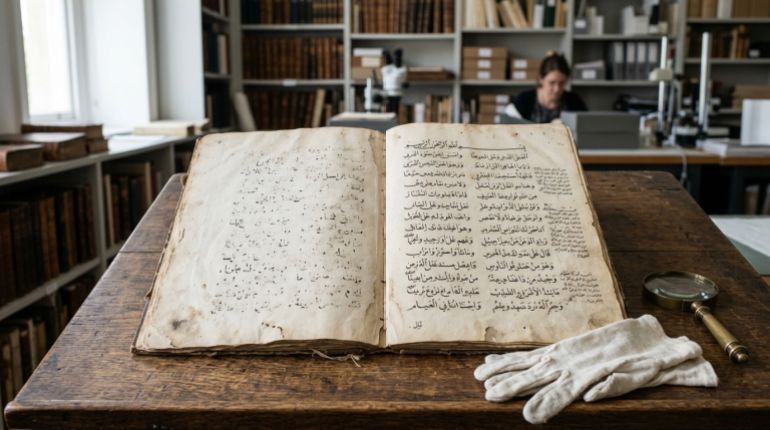
لهذا يرى مبارك أن رقمنة الذاكرة العربية لا ينبغي أن تقاس فقط بعدد الصفحات التي تحولت إلى نصوص، وإنما بمدى أمانة النص المستخرج للمصدر الأصلي، واحتفاظه ببنية الوثيقة وسياقها ومصدرها، ومعرفة مستوى الثقة في عملية استخراجه.
وفي المقابل، يشير إلى أنه يمكن استخدام الذكاء الاصطناعي نفسه في مرحلة التحقق، من خلال اكتشاف أخطاء "أو سي آر"، ومقارنة النص المستخرج بصورة الصفحة، والتحقق من اتساقه مع النص والسياق. ولكن ذلك يتطلب الاحتفاظ بصورة الوثيقة الأصلية إلى جانب النص، بحيث تظل النتائج قابلة للمراجعة والتحقق.
عندما تصبح الذاكرة قابلة للقراءة الآلية
تكشف رحلة رقمنة الذاكرة العربية أن تحويل الصفحة إلى ملف رقمي ليس سوى الطبقة الأولى من العملية. فالبيانات التي تتعلم منها الآلات تحتاج إلى أن تكون قابلة للقراءة، لكنها تحتاج أيضا إلى أن تبقى مرتبطة بالوثيقة التي جاءت منها والسياق الذي يمنحها معناها.
وتكشف "سرد" حجم البيانات المطلوبة لتعليم الآلة قراءة الصفحات العربية، بينما تبين الوثائق الحقيقية أن التحدي لا ينتهي عند استخراج النص، بل يمتد إلى التحقق من دقته والحفاظ على بنية الصفحة ومصدرها.
وفي النهاية، لا تكمن قيمة رقمنة الذاكرة العربية في عدد الصفحات التي تحولت إلى نصوص فحسب، بل في قدرة هذه النصوص على البقاء أمينة للوثائق التي حفظت تلك الذاكرة، وقابلة للبحث والاستخدام دون أن تنقطع صلتها بأصولها.